基于多模态模型(ASR+VL+TTS)的视觉情感陪聊功能实现
背景
最近 AI 情感陪伴的机器人和玩具新增了很多玩家,很多客户也都有类似的需求。
近期有几个客户在相关场景,希望实现如下功能:
– 实现人脸追踪,根据人脸的位置实现摄像头上下左右转动对准人脸;
– 模型根据人的表情或者对话的语境给出相应的表情或者情绪反馈;
有些功能通过百炼的多模态交互开发套件不一定能满足需求,可能需要基于各个模型的原子能力自己搭建整套链路。
本文尝试借助 Qoder 利用阿里云百炼中合适的 ASR+LLM(VL)+TTS 模型搭建完整的视频+语音交互链路。
需求文档
一、项目概述
基于阿里云百炼平台,构建一个具备视觉理解能力的全双工实时陪聊机器人,支持语音和视频交互。
注:
人脸追踪,本质是识别到摄像头视频内人脸,并给出坐标位置,然后电机控制摄像头做对应位移,让人脸挪到画面中心。
拆解关键步骤如下:
1. 视频流传给VL模型;
2. VL模型根据提示词,给出人脸坐标;
3. 电机控制做对应位置更新。
本demo不涉及硬件控制,只实现前两步。
二、技术选型
| 功能模块 | 模型/技术 | 用途 | 官方文档 |
|---|---|---|---|
| ASR | qwen3-asr-flash-realtime | 实时语音识别 | 文档链接 |
| LLM | qwen3-vl-plus | 视频/图片多模态理解 + 文字闲聊 | 文档链接 |
| TTS | cosyvoice-v3-flash | 文字转语音(音色:longanhuan) | 文档链接 |
| 通信 | WebSocket | 前后端实时双向通信 | – |
| 平台 | 阿里云百炼 DashScope | API服务平台 | 模型列表 |
三、功能需求
3.1 语音识别(ASR)
| 需求项 | 描述 | 状态 |
|---|---|---|
| 实时识别 | 使用WebSocket流式传输音频数据 | ✅ 已实现 |
| 全双工对话 | 无需按住按钮,持续监听用户语音 | ✅ 已实现 |
| 服务端VAD | 由服务端进行语音活动检测 | ✅ 已实现 |
| 自动发送 | 检测到用户说完话后自动发送 | ✅ 已实现 |
| 消息队列 | 多条消息排队处理,避免丢失 | ✅ 已实现 |
| 实时转录 | 前端实时显示识别中的文字 | ✅ 已实现 |
3.2 多模态理解(LLM)
| 需求项 | 描述 | 状态 |
|---|---|---|
| 文字对话 | 支持纯文字闲聊 | ✅ 已实现 |
| 图片理解 | 支持图片输入进行视觉理解 | ✅ 已实现 |
| 视频理解 | 定期捕获视频帧发送给模型 | ✅ 已实现 |
| 流式输出 | 对话内容流式返回并显示 | ✅ 已实现 |
| 对话历史 | 保持上下文(最近10轮) | ✅ 已实现 |
| 情绪陪伴 | 温暖、善解人意的对话风格 | ✅ 已实现 |
3.3 语音合成(TTS)
| 需求项 | 描述 | 状态 |
|---|---|---|
| 语音播放 | AI回复转为语音播放 | ✅ 已实现 |
| 指定音色 | 使用 longanhuan 音色 | ✅ 已实现 |
| 流式输出 | 边合成边播放,降低首字延迟 | ✅ 已实现 |
| 用户打断 | 用户说话时可打断AI语音 | ✅ 已实现 |
| 服务端打断保护 | TTS启动后1.5秒内不响应打断 | ✅ 已实现 |
| 前端打断保护 | 播放开始后2秒内不响应打断(防回声) | ✅ 已实现 |
| 连续检测确认 | 需连续3次检测到语音才触发打断 | ✅ 已实现 |
流式TTS工作流程:
LLM输出完成
    ↓
TTS开始流式合成 → 发送 tts_start
    ↓
收到音频块 → 立即发送 tts_chunk
    ↓
前端累积3个音频块 → 开始播放
    ↓
边接收边播放,大幅降低延迟
    ↓
合成完成 → 发送 tts_end
3.4 AI表情反馈
| 需求项 | 描述 | 状态 |
|---|---|---|
| 结构化输出 | LLM以 [EMOTION:xxx] 格式输出表情 | ✅ 已实现 |
| 表情解析 | 后端解析表情标记并分离内容 | ✅ 已实现 |
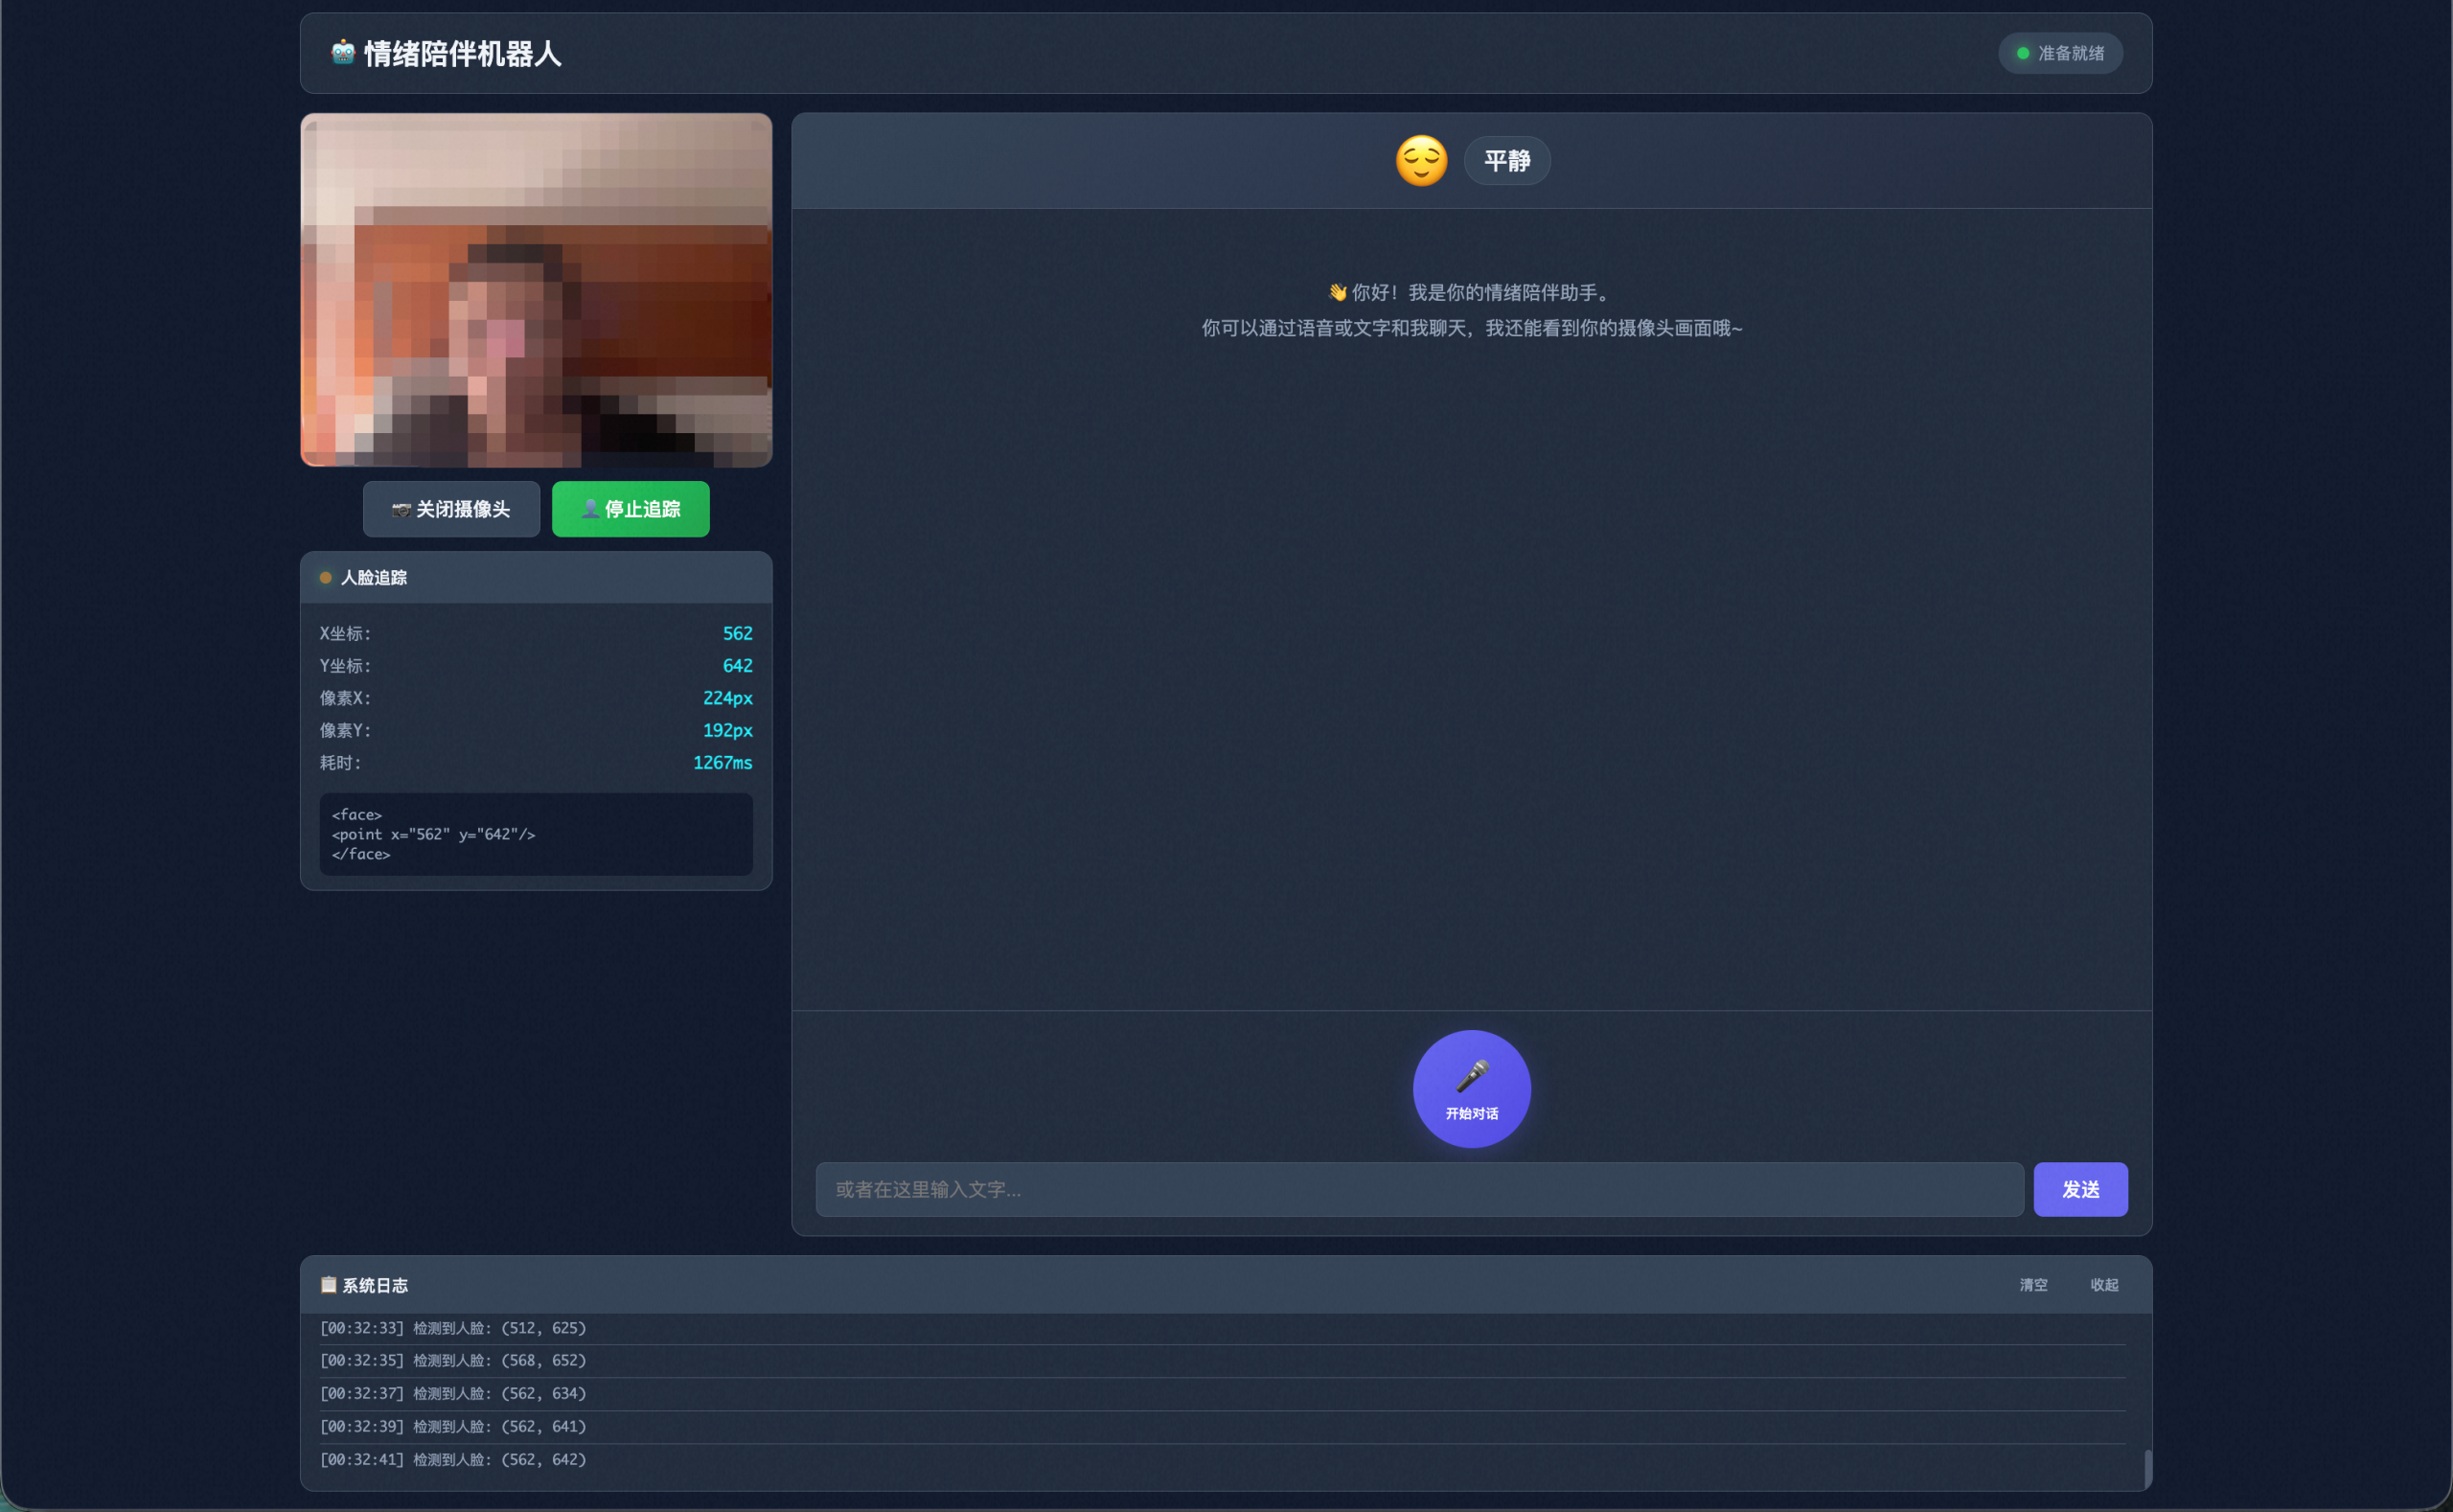
| 前端显示 | 大emoji + 标签显示AI当前情绪 | ✅ 已实现 |
| 动画效果 | 表情切换时弹跳动画 | ✅ 已实现 |
支持的表情类型:
| 表情名 | Emoji | 含义 | 标签颜色 |
|---|---|---|---|
| happy | 😊 | 开心、兴奋、高兴 | 绿色 |
| sad | 😢 | 难过、同情、安慰 | 蓝色 |
| love | 🥰 | 关爱、喜欢、温暖 | 粉色 |
| thinking | 🤔 | 思考、疑惑、好奇 | 橙色 |
| surprised | 😮 | 惊讶、意外 | 紫色 |
| neutral | 😌 | 平静、中性 | 灰色 |
3.5 人脸追踪
| 需求项 | 描述 | 状态 |
|---|---|---|
| 人脸检测 | 使用VL模型检测人脸位置 | ✅ 已实现 |
| 坐标输出 | 输出人脸中心点坐标(x, y) | ✅ 已实现 |
| 可视化标记 | 在视频画面上显示追踪点 | ✅ 已实现 |
| 实时更新 | 定时检测并更新位置 | ✅ 已实现 |
3.6 前端界面
| 需求项 | 描述 | 状态 |
|---|---|---|
| 摄像头预览 | 调用并显示摄像头画面 | ✅ 已实现 |
| 对话区域 | 显示用户和AI的对话气泡 | ✅ 已实现 |
| 表情显示区 | 显示AI当前表情状态 | ✅ 已实现 |
| 状态指示器 | 显示系统当前状态 | ✅ 已实现 |
| 系统日志 | 显示错误和状态日志 | ✅ 已实现 |
| 文字输入 | 支持键盘输入文字发送 | ✅ 已实现 |
| 语音控制 | 开始/结束对话按钮 | ✅ 已实现 |
四、交互流程
4.1 全双工语音对话流程
用户点击"开始对话"
    ↓
建立ASR WebSocket连接
    ↓
持续捕获并发送音频数据
    ↓
服务端VAD检测语音活动
    ↓
检测到语音结束 → 触发识别完成
    ↓
识别结果加入消息队列
    ↓
处理队列 → 调用LLM生成回复
    ↓
解析表情 + 更新前端显示
    ↓
TTS合成并播放语音
    ↓
用户可随时打断继续对话
4.2 打断机制
服务端打断保护:
1. TTS启动后记录时间戳
2. 收到打断请求时检查是否超过1.5秒
3. 未超过则忽略打断请求
前端打断保护:
1. 播放开始后2秒内不检测语音活动(避免回声触发)
2. 需要连续检测到3次语音活动才触发打断
3. 打断后清空TTS缓存,重置状态
五、技术架构
┌─────────────────────────────────────────────────────────┐
│                      前端 (Browser)                      │
│  ┌─────────┐  ┌─────────┐  ┌─────────┐  ┌─────────┐    │
│  │ 摄像头  │  │ 麦克风  │  │ 对话UI │  │ 表情显示│    │
│  └────┬────┘  └────┬────┘  └────┬────┘  └────┬────┘    │
│       │            │            │            │          │
│       └────────────┴────────────┴────────────┘          │
│                         │                               │
│                    WebSocket                            │
└─────────────────────────┼───────────────────────────────┘
                          │
┌─────────────────────────┼───────────────────────────────┐
│                      后端 (Node.js)                      │
│                         │                               │
│  ┌──────────────────────┴──────────────────────┐       │
│  │              WebSocket Server                │       │
│  └──────────────────────┬──────────────────────┘       │
│                         │                               │
│  ┌─────────┐  ┌─────────┴─────────┐  ┌─────────┐       │
│  │   ASR   │  │        LLM        │  │   TTS   │       │
│  │ Service │  │      Service      │  │ Service │       │
│  └────┬────┘  └─────────┬─────────┘  └────┬────┘       │
└───────┼─────────────────┼─────────────────┼─────────────┘
        │                 │                 │
        └─────────────────┼─────────────────┘
                          │
┌─────────────────────────┼───────────────────────────────┐
│               阿里云百炼 DashScope API                   │
│  ┌─────────────┐  ┌─────────────┐  ┌─────────────┐     │
│  │ qwen3-asr   │  │ qwen3-vl    │  │ cosyvoice   │     │
│  │ flash       │  │ plus        │  │ v3-flash    │     │
│  └─────────────┘  └─────────────┘  └─────────────┘     │
└─────────────────────────────────────────────────────────┘
六、项目结构
20260130_桌面情绪陪伴demo/
├── server/
│   ├── index.js              # 主服务入口
│   └── services/
│       ├── asr.js            # ASR语音识别服务
│       ├── llm.js            # LLM多模态理解服务
│       ├── tts.js            # TTS语音合成服务
│       └── faceTracking.js   # 人脸追踪服务
├── public/
│   ├── index.html            # 前端页面
│   ├── main.js               # 前端交互逻辑
│   └── styles.css            # 样式文件
├── package.json
└── docs/
    └── 需求文档.md
七、配置信息
- API Key: sk-XXXXXXXX
- 服务端口: 3000
- 音频采样率: 16000 Hz
- VAD阈值: 0.3
- VAD静音时长: 700ms
- VAD前缀填充: 300ms
- TTS打断保护期: 1500ms
- 图像捕获间隔: 2000ms
- 人脸检测间隔: 1000ms
实现效果
可把上述需求文档写成.md 文件给到 Qoder 做代码实现。
生成前端页面如下图。
实现效果视频如下。
总结与后续优化方向
- 通过 Qoder 可以快速搭建特定场景的 demo;
- Qwen3-VL 模型在图片理解、闲聊陪伴、指令循序的能力上都比较均衡,如果客户没有特别复杂的场景或者要求,可以尝试只用一个 VL 模型完成所有的图像+文本处理,无需额外的工作流;
- 本文在没有做特别延时优化的情况下,个人感觉延时水平已经是 C 端用户可接受的水平了;
- 本文没有做单独的 LLM 提示词调优,未来基于不同客户的要求和产品设定,可以设置有特定性格或语言特点的提示词;
- TTS 可以按需进行音色复刻后使用,以实现产品差异化。